Skip to content

What’s new in scanned music import

How Flat turns PDFs and photos of sheet music into editable scores: model versions, what is recognized, what got fixed.

The same engine powers Opuscan and the OMR API. This page lists the changes as they reach Flat.

All changes

条目由英文自动翻译而来。 阅读英文原文

在九月期间

24 项较小改动
8月7日·改进·

支持隐式连音的新模型版本

我们自研模型的新版本现已用于所有 PDF 和照片导入,重点改进了对页面上连音组印刷方式的识别。

  • 现已支持隐式连音。 制谱人员通常只会在一段乐句中第一组三连音或六连音上方标一个小小的“3”或“6”,后续同样的分组则不再重复标注——默认演奏者会延续这一模式。这些没有标记的分组就是隐式连音:实际要按连音演奏,但页面上没有明确写出来。它们在 19 世纪版本、练习曲和变奏曲中非常常见。现在,扫描会根据小节的节奏将它们还原出来,而不是为了让小节符合拍号而删掉音符。
  • 凭空生成的连音更少了。 过去,即使普通的符杠分组上方没有印数字,模型也可能把它们识别成三连音,于是这些数字会出现在你的乐谱里。现在,只有页面上确实画出了连音标记的地方,才会写入连音。
8月4日·新增·

在桌面应用中导入 PDF 或照片

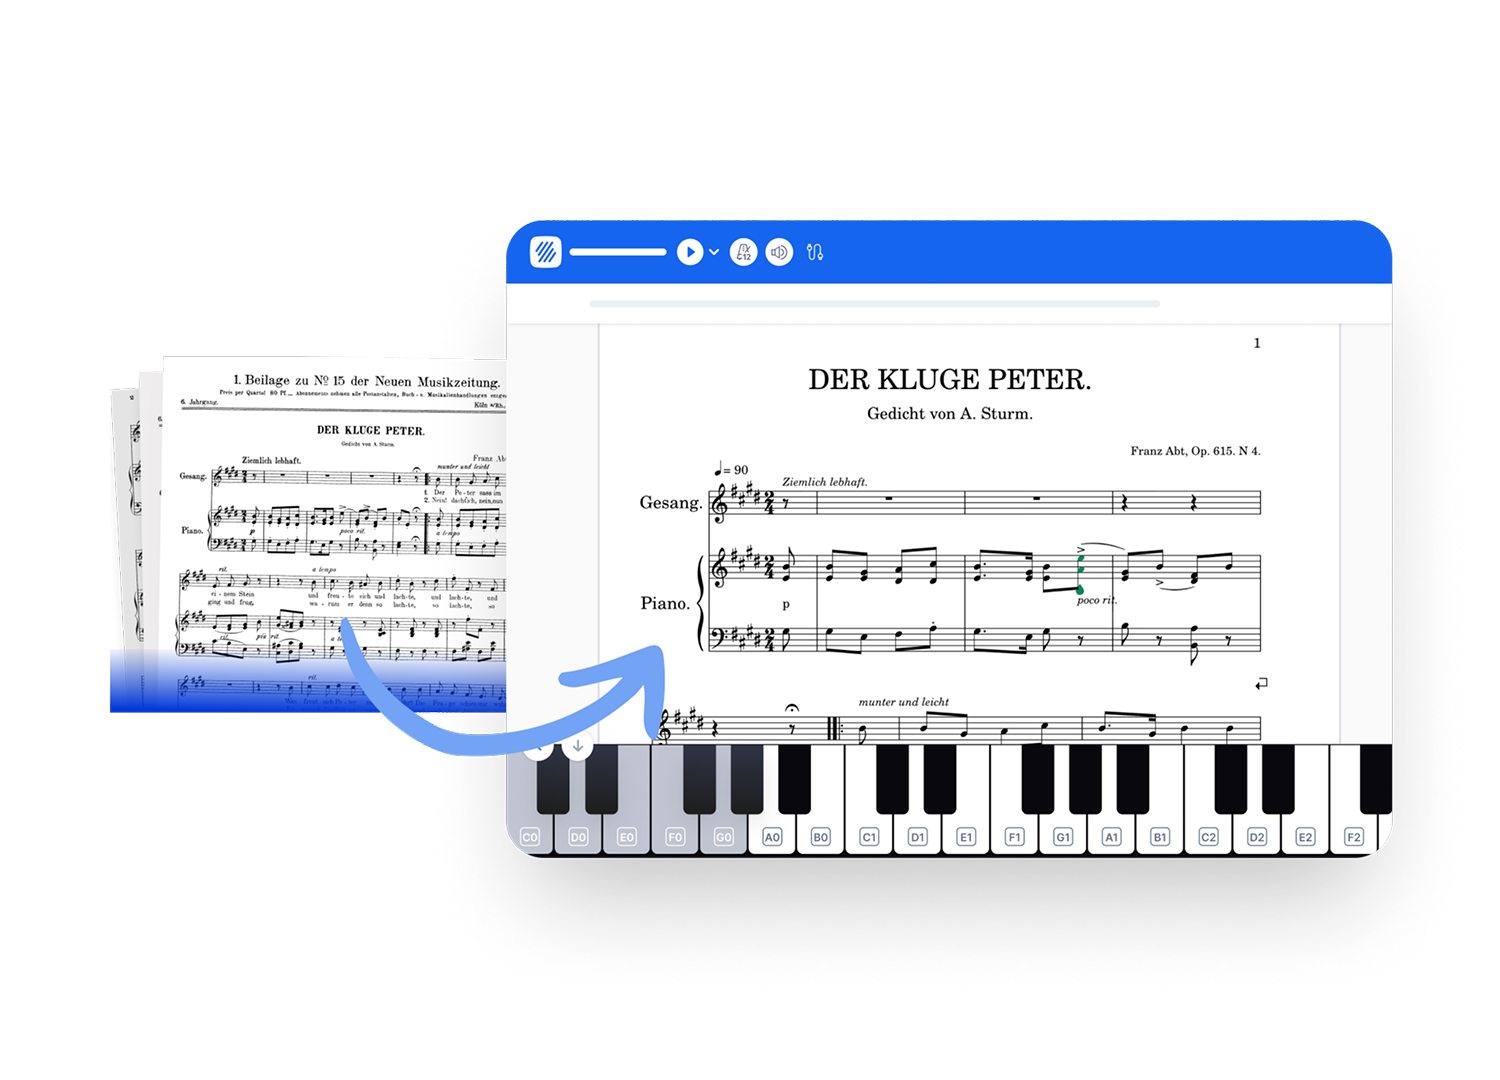
在 Flat 中,印刷乐谱变为可编辑乐谱

Mac 和 Windows 应用现在可以将 PDF 或纸质乐谱照片转换为可编辑乐谱,并提供与网页版相同的检查步骤。

  • 无需离开应用即可导入。 选择文件,检查扫描识别结果,然后打开乐谱。
  • 可在 Mac App Store 版应用内购买 AI credits,这样导入时就不必再跳转到网站。

也在 八月 月

16 项较小改动
7月24日·改进·

新版模型重点修复记谱问题

Flat 自研模型的改进版本现已用于所有 PDF 和照片导入,尤其包括:

  • 现已支持带共享休止符和隐藏休止符的多声部段落。
  • 小节线和反复结束括号(volta)现在可以在小节内正确放置。
  • 连梁的识别现在更可靠。
  • 现在可以识别像管弦乐总谱那样跨多个谱表绘制的拍号。
  • 修复了部分和弦符号导出到 MusicXML 时使用非标准和弦类型的问题。
7月15日·新增·

将 PDF 或照片导入为可编辑乐谱,并带有复核步骤

在网页版应用中,从 PDF 或照片导入乐谱现已采用新的流程,基于 Flat 自研的识别引擎。它将为所有用户替代此前的 PDF 导入方式。

  • 选择你需要的页面。 上传一个 PDF 或多张照片,然后只保留包含乐谱的页面。每保留一页都会消耗 1 个额度。
  • 在识别进行时查看进度。 进度条会按页面显示扫描进行到哪一步,并且你可以在处理期间继续使用 Flat。
  • 在生成乐谱前先复核。 当识别引擎无法确定某个乐器时,它会请你确认标题以及识别出的乐器,并在每个乐器旁显示该页面上印刷的声部名称。如果所有乐器都能被明确识别,则会跳过此步骤。

Flat 现已提供此功能;对于教师和管理员,也可在 Flat for Education 中使用。新流程将在未来几周内登陆 iOS 应用。

7月10日·新增·

OMR 现已作为开发者 API 提供

Flat 的 OMR 引擎现已可通过开发者 API以编程方式使用。您可以发送 PDF 或照片,跟踪识别进度,检查识别出的乐器,然后将结果作为可编辑的乐谱导入 Flat 资料库,或导出为 MusicXMLMIDI。这与编辑器中用于导入 PDF 和照片的内部模型相同,现在也可大规模用于您自己的应用和工作流程。

专用 OMR API(v2.24.0)建立在 v2.23.0 中添加到乐谱创建流程的后台 PDF 导入功能之上:导入文件时请求任务支持,并轮询该任务直到乐谱准备就绪。有关这两个版本的详细信息,请参阅 API 更新日志

也在 七月 月

9 项较小改动
6月23日·改进·

针对复杂版面的页面分析更精准

我们改进了扫描时对页面版面的读取方式。现在导入 PDF 和照片时,生成的乐谱会更干净、更准确,尤其是在复杂版面中:

  • 内容密集的页面现在能正确拆分。 对于上下堆叠了许多短行谱表的页面,不会再被合并到一起——每个系统都会被单独检测出来。
  • 更适合管弦乐总谱和大型合奏总谱。 钢琴、管风琴等多谱表乐器,以及包含许多谱表的大型总谱,现在都能更可靠地识别。
  • 宽版、横向和小册子版式。 横向页面的左边缘不再被裁切(否则可能会切掉谱号),多页扫描和小册子扫描现在也能被正确处理。
  • 更少的误检。 页面页脚和边距附近的无关元素不再被误识别为音乐内容。
6月15日·改进·

更精确的模型

现在,所有 PDF 和照片导入都会由 Flat 自研的内部模型处理。这个版本是一次重要的新版本更新,重点提升了转谱准确性:在所有测试集中,乐谱的音乐正确性(决定乐谱是否正确的音符、节奏、连结线和临时记号)都有所提升,其中提升最明显的是:

  • 力度记号:+39%
  • 延长记号、演奏法、连结线、临时记号:+30 to 37%
  • 音符时值:+22%
  • 连线、附点音符、休止符、谱表和声部分配:+14 to 20%

文本、力度记号和版面位置也更加精确:歌词、和弦名称和力度记号现在能更可靠地附着到正确的音符上,包括钢琴大谱表以及带有谱号变化的声部等复杂版面。

6月1日·新增·

我们自研的 AI 模型开始逐步上线

我们正在逐步上线 Flat 自研的 PDF 和照片导入 AI 模型。该模型由我们内部设计并训练,用来替代产品上线时使用的第三方引擎。拥有端到端的技术能力后,我们可以进一步提升准确率,扩展可识别的记谱内容,更快交付改进,并让识别结果更好地贴合 Flat 自身的乐谱格式,使导入内容能够更自然地融入产品的其余部分。仅首个版本,就已经能读出你乐谱中更多的内容:

更广的记谱覆盖范围。 新增可识别内容:

  • 和弦符号,会按其音乐含义正确编码为可编辑的和弦,而不只是普通文本
  • 小节反复记号和节奏斜线
  • 速度标记和节拍器标记(含 BPM)

支持更多语言的歌词和文本。 现在默认可识别使用拉丁字母的语言中的歌词、排练记号及其他文本,同时也支持日语、韩语和中文。

更贴近原始版面。 现在导入结果会更紧密地遵循源乐谱的版面布局,包括每行的小节数、每页的系统数以及整体结构。这对于大型复杂乐谱(如管弦乐作品)以及钢琴这类多谱表乐器尤其有帮助。现在还支持更多页面格式,包括此前不支持的横向页面。

也在 六月 月

8 项较小改动

在找更早的内容?

较早的更新会按版本发布在 Flat 博客中。